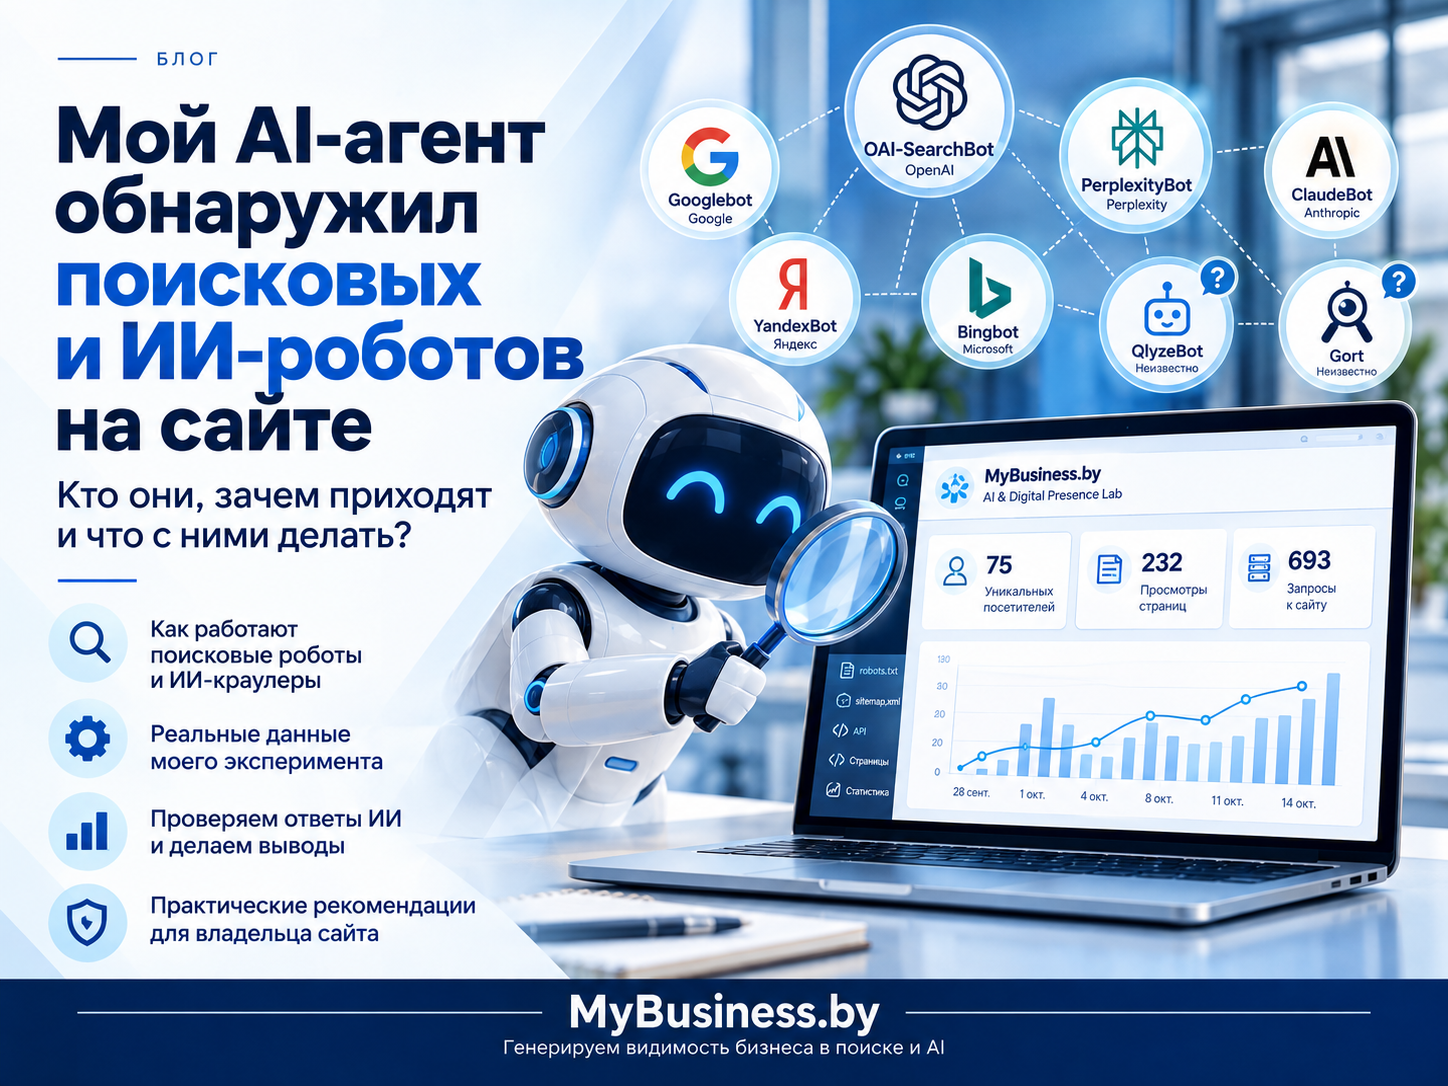
В 2026 году на сайт приходят не только потенциальные клиенты. Его посещают поисковые роботы Google, Яндекса, Bing, а также автоматизированные системы OpenAI, Perplexity, Anthropic и других компаний.
Я обнаружила их в ежедневном отчёте своего AI-агента и решила разобраться, зачем они приходят, что это означает для SEO, GEO и AI Search и нужно ли владельцу сайта что-то предпринимать.
В этой статье – простые определения, мой эксперимент с сайтом, созданным в ChatGPT, реальные показатели серверных запросов, диалог с Google ИИ и практические рекомендации для малого бизнеса.
Я обнаружила их в ежедневном отчёте своего AI-агента и решила разобраться, зачем они приходят, что это означает для SEO, GEO и AI Search и нужно ли владельцу сайта что-то предпринимать.
В этой статье – простые определения, мой эксперимент с сайтом, созданным в ChatGPT, реальные показатели серверных запросов, диалог с Google ИИ и практические рекомендации для малого бизнеса.
Что такое поисковые роботы и ИИ-краулеры
Поисковый робот (Search Engine Crawler) – автоматизированная программа, которая посещает сайты, получает содержимое страниц, переходит по ссылкам и помогает поисковой системе обнаруживать новую информацию и изменения.
Например, Googlebot работает для Google, YandexBot – для Яндекса, Bingbot – для Microsoft Bing.
Благодаря этим роботам поисковые системы могут находить и индексировать страницы сайтов. Однако посещение роботом не гарантирует индексацию или высокие позиции в поисковой выдаче.
ИИ-краулер (AI Crawler) – автоматизированная программа, которая получает информацию с сайтов для задач, связанных с искусственным интеллектом.
Например, Googlebot работает для Google, YandexBot – для Яндекса, Bingbot – для Microsoft Bing.
Благодаря этим роботам поисковые системы могут находить и индексировать страницы сайтов. Однако посещение роботом не гарантирует индексацию или высокие позиции в поисковой выдаче.
ИИ-краулер (AI Crawler) – автоматизированная программа, которая получает информацию с сайтов для задач, связанных с искусственным интеллектом.
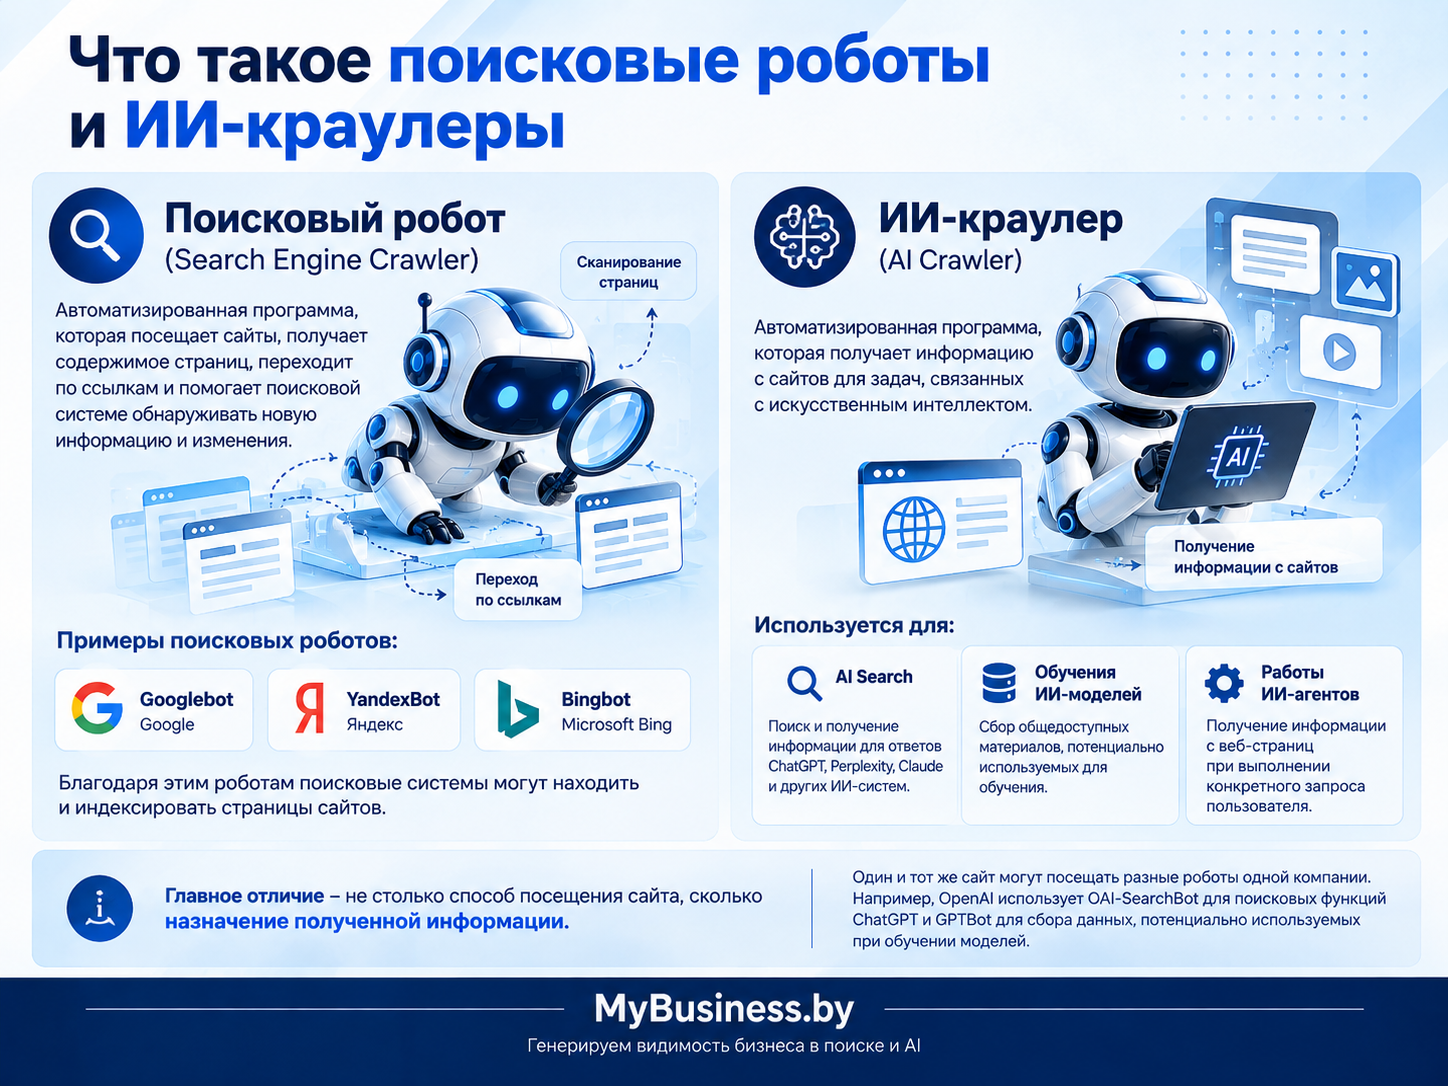
В зависимости от назначения ИИ-краулеры могут использоваться для:
- AI Search – поиска и получения информации для ответов ChatGPT, Perplexity, Claude и других ИИ-систем.
- Обучения ИИ-моделей – сбора общедоступных материалов, потенциально используемых для обучения.
- Работы ИИ-агентов – получения информации с веб-страниц при выполнении конкретного запроса пользователя.
Главное отличие между этими системами – не столько способ посещения сайта, сколько назначение полученной информации.
Современные поисковые системы тоже используют искусственный интеллект, поэтому граница между классическим поиском и AI Search постепенно становится менее строгой.
Таблица 1. Основные категории поисковых и ИИ-роботов
Важно: робот посетил сайт, поисковая система обнаружила страницу, ИИ использовал информацию в ответе, пользователь перешёл по ссылке – это разные события. Одно не гарантирует другое.
Один и тот же сайт могут посещать разные роботы одной компании. Например, OpenAI использует OAI-SearchBot для поисковых функций ChatGPT и GPTBot для сбора данных, потенциально используемых при обучении моделей. Поэтому при настройке доступа важно учитывать назначение конкретного робота, а не только название компании.
Как мой AI-агент обнаружил роботов на сайте
В сентябре 2026 года я создала отдельный экспериментальный сайт MyBusiness.by – AI & Digital Presence Lab внутри ChatGPT. Это дополнительная площадка проекта MyBusiness.by, посвящённая цифровому присутствию бизнеса, SEO, GEO и AI Search.
На сайте работает инструмент Digital Presence Quick Check, который позволяет проверить ряд технических параметров сайта: доступность, HTTPS, метатеги, заголовки, robots.txt, sitemap.xml, структурированные данные и другие элементы.
Мне было интересно не только создать сайт с помощью ИИ, но и исследовать, как он обнаруживается поисковыми системами и сервисами AI Search. Для этого я настроила ежедневный мониторинг с помощью AI-агента.
Он анализирует доступные журналы Cloudflare Worker, данные Quick Check, технические ошибки и результаты контрольных поисковых проверок.
Что показал отчёт за 13 октября 2026 года. Утром я получила отчёт за предыдущие сутки – с 00:00 до 23:59.
На сайте работает инструмент Digital Presence Quick Check, который позволяет проверить ряд технических параметров сайта: доступность, HTTPS, метатеги, заголовки, robots.txt, sitemap.xml, структурированные данные и другие элементы.
Мне было интересно не только создать сайт с помощью ИИ, но и исследовать, как он обнаруживается поисковыми системами и сервисами AI Search. Для этого я настроила ежедневный мониторинг с помощью AI-агента.
Он анализирует доступные журналы Cloudflare Worker, данные Quick Check, технические ошибки и результаты контрольных поисковых проверок.
Что показал отчёт за 13 октября 2026 года. Утром я получила отчёт за предыдущие сутки – с 00:00 до 23:59.
Таблица 2. Сравнение серверной активности 12 и 13 октября
Из 14 серверных запросов 13 были классифицированы по User-Agent как обращения автоматизированных систем.
В журналах фигурировали:
Последние два имени оказались для меня особенно интересными, поскольку их происхождение и назначение требовали дополнительной проверки. Все 14 запросов завершились с HTTP 200. Ошибок Cloudflare Worker и ответов HTTP 404 не обнаружено.
Но 13 запросов роботов – это не 13 посетителей. Серверный запрос является техническим событием, а не подтверждённым посещением человека.
Кроме того, название User-Agent можно подделать. Поэтому идентификаторы роботов в журналах ещё не означают, что их подлинность подтверждена по IP-адресам.
В журналах фигурировали:
- OAI-SearchBot – OpenAI;
- PerplexityBot – Perplexity;
- ClaudeBot – Anthropic;
- Bingbot – Microsoft;
- QlyzeBot;
- Gort.
Последние два имени оказались для меня особенно интересными, поскольку их происхождение и назначение требовали дополнительной проверки. Все 14 запросов завершились с HTTP 200. Ошибок Cloudflare Worker и ответов HTTP 404 не обнаружено.
Но 13 запросов роботов – это не 13 посетителей. Серверный запрос является техническим событием, а не подтверждённым посещением человека.
Кроме того, название User-Agent можно подделать. Поэтому идентификаторы роботов в журналах ещё не означают, что их подлинность подтверждена по IP-адресам.
Почему меня заинтересовал OAI-SearchBot
В отчёте я обратила внимание на OAI-SearchBot – робота OpenAI, связанного с поисковыми функциями ChatGPT. За 13 октября он дважды обратился к файлу /robots.txt. Оба запроса получили HTTP 200.
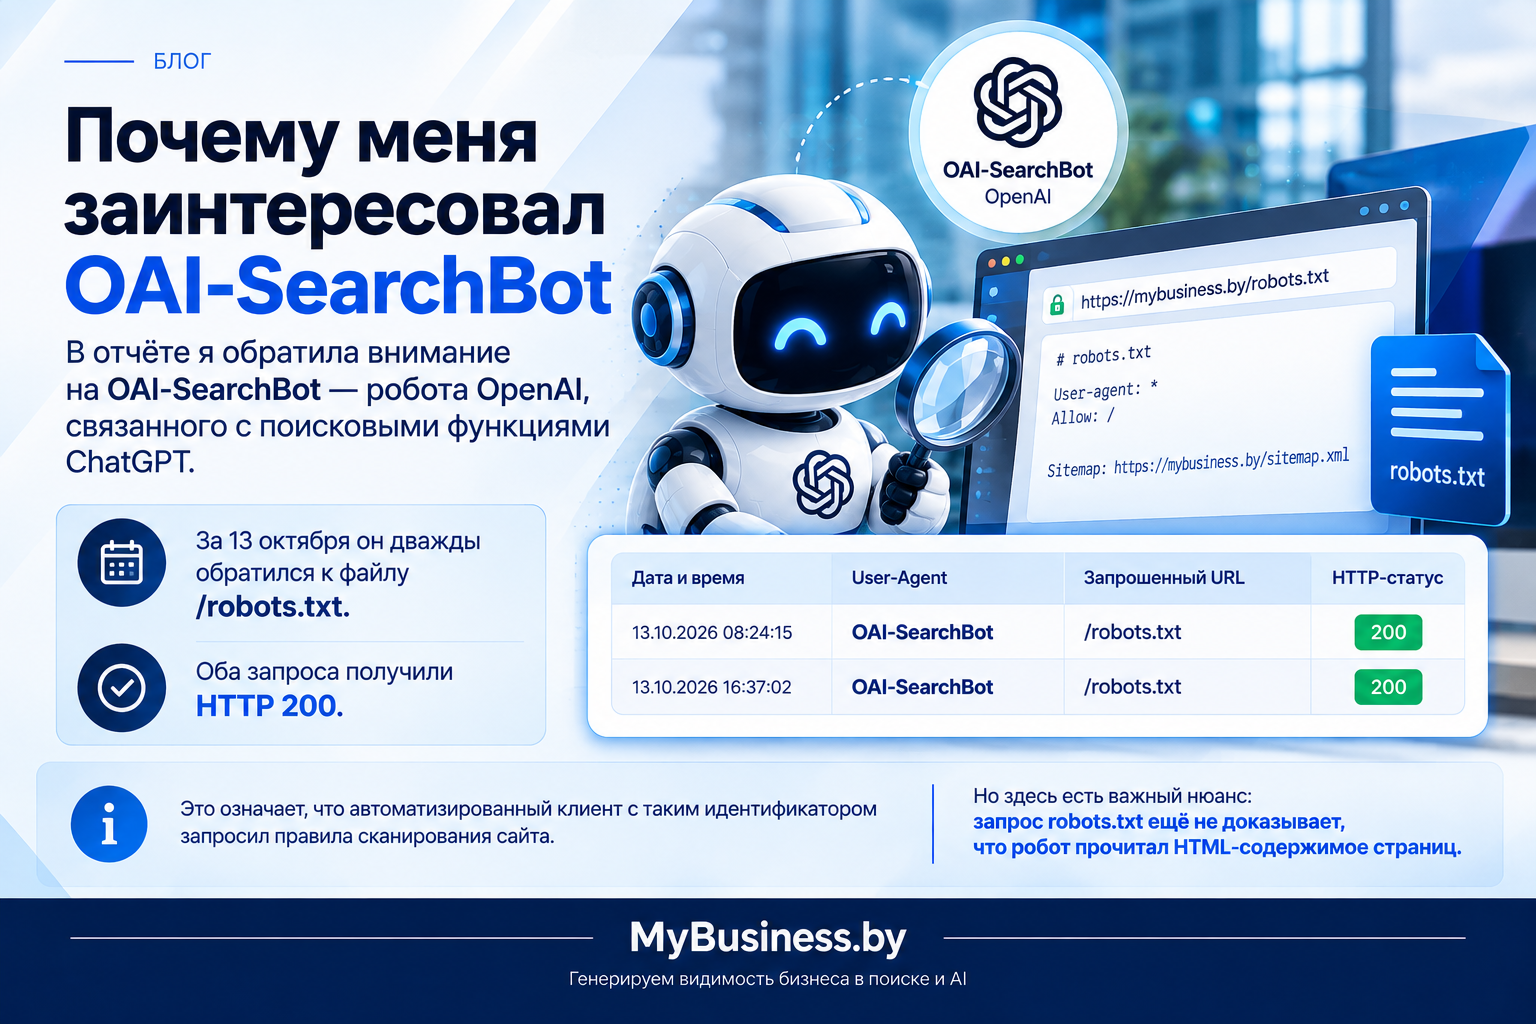
Это означает, что автоматизированный клиент с таким идентификатором запросил правила сканирования сайта. Но здесь есть важный нюанс: запрос robots.txt ещё не доказывает, что робот прочитал HTML-содержимое страниц.
Что показала контрольная проверка ChatGPT Search
14 октября я дополнительно проверила запрос Digital Presence Quick Check. В результатах ChatGPT Search были обнаружены две страницы Lab – русская и английская.
Это интересный результат моего эксперимента. Однако он подтверждает обнаружение страниц только в рамках одного проверенного запроса. Он не показывает, сколько раз сайт появлялся в ответах ChatGPT другим пользователям и сколько людей перешли по ссылкам.
Также нельзя утверждать, что именно два запроса OAI-SearchBot к robots.txt привели к появлению страниц в результатах поиска.
Это интересный результат моего эксперимента. Однако он подтверждает обнаружение страниц только в рамках одного проверенного запроса. Он не показывает, сколько раз сайт появлялся в ответах ChatGPT другим пользователям и сколько людей перешли по ссылкам.
Также нельзя утверждать, что именно два запроса OAI-SearchBot к robots.txt привели к появлению страниц в результатах поиска.
Что показала аналитика Lab на утро 15 октября
Я отдельно сравнила отчёт AI-агента с панелью ChatGPT Sites Analytics.
По состоянию на утро 15 октября 2026 года накопительная статистика экспериментального сайта составила:
По сравнению с предыдущим замером количество уникальных посетителей не изменилось, просмотров стало на два больше, а серверных запросов – на шесть.
По состоянию на утро 15 октября 2026 года накопительная статистика экспериментального сайта составила:
- 75 уникальных посетителей;
- 232 просмотра страниц;
- 693 серверных запроса.
По сравнению с предыдущим замером количество уникальных посетителей не изменилось, просмотров стало на два больше, а серверных запросов – на шесть.
Таблица 3. Изменение основных показателей Lab
Особенно меня заинтересовали запросы к техническим адресам сайта.
Таблица 4. Наиболее запрашиваемые пути
За время между двумя замерами число запросов к /robots.txt увеличилось со 114 до 116. Однако по одной этой статистике невозможно определить, какие именно роботы выполнили два новых запроса.
В панели также отображаются уточнённые данные за 14 октября: два уникальных посетителя и четыре просмотра страниц, включая два просмотра типа embedded_page.
В панели также отображаются уточнённые данные за 14 октября: два уникальных посетителя и четыре просмотра страниц, включая два просмотра типа embedded_page.
Что это означает? Сайт продолжает получать обращения, в том числе к техническим файлам. Но пока нет оснований утверждать, что аудитория устойчиво растёт именно благодаря AI Search.
Важно учитывать, что Cloudflare Worker и ChatGPT Sites Analytics измеряют разные события. Серверные запросы, вызовы API, просмотры страниц и уникальные посетители нельзя считать взаимозаменяемыми показателями.
Какие роботы сегодня посещают сайты
Не все роботы выполняют одинаковые функции.
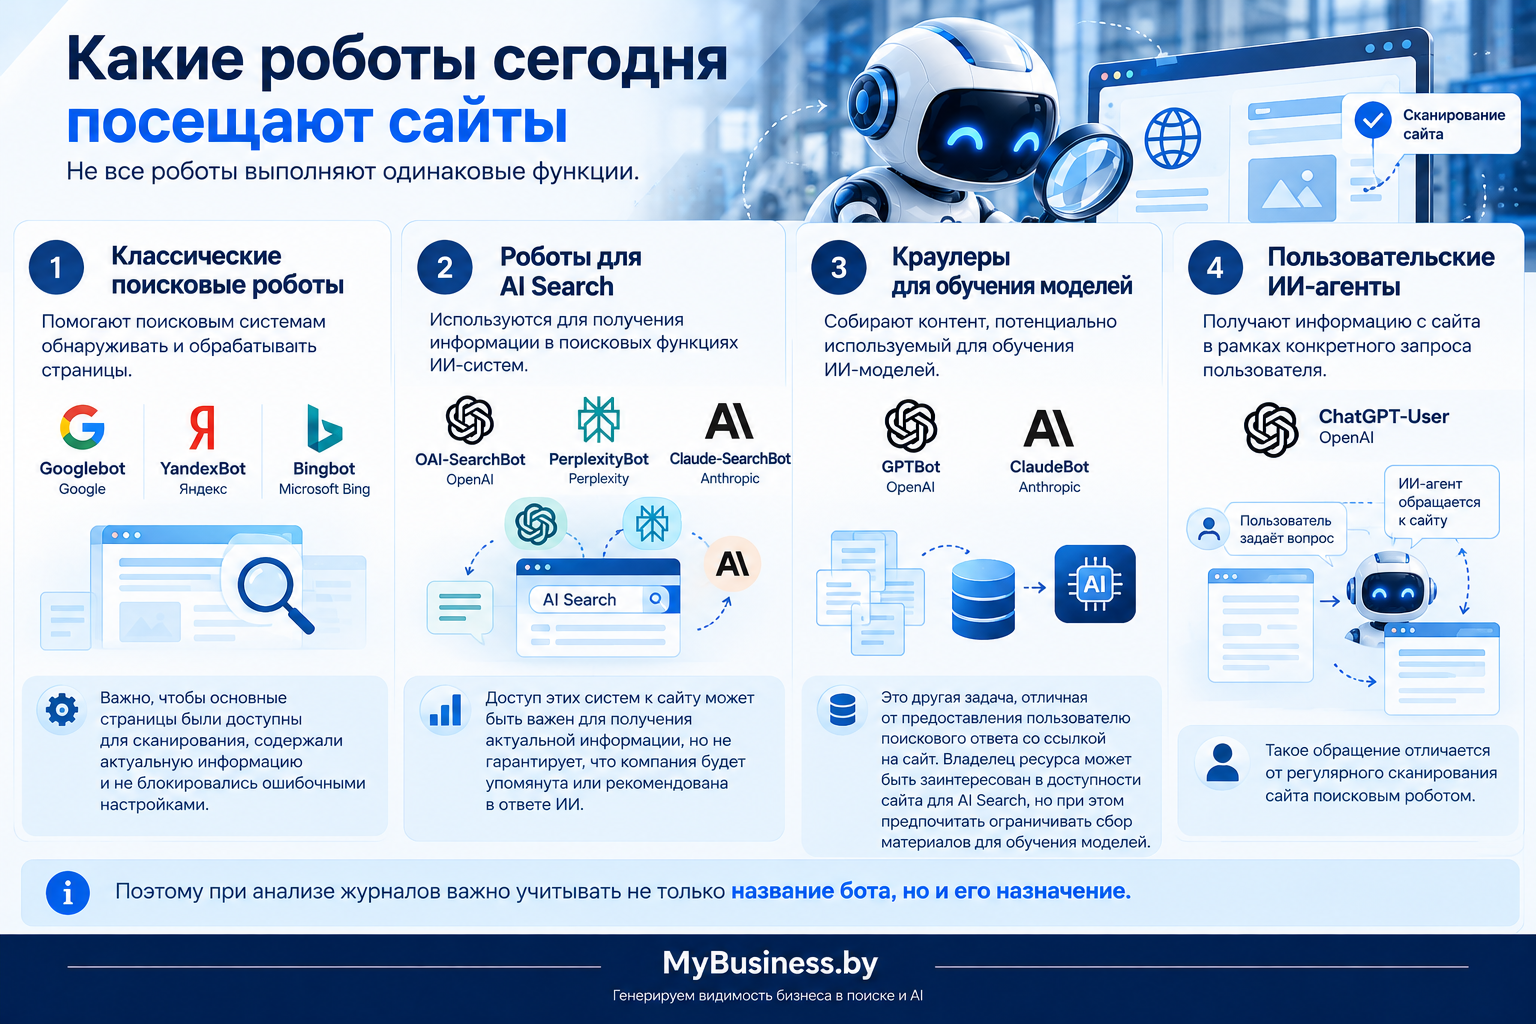
Классические поисковые роботы: Googlebot, YandexBot и Bingbot помогают поисковым системам обнаруживать и обрабатывать страницы. Для владельца бизнеса важно, чтобы основные страницы были доступны для сканирования, содержали актуальную информацию и не блокировались ошибочными настройками.
Роботы для AI Search. К этой категории относятся:
OAI-SearchBot – робот OpenAI, связанный с поисковыми функциями ChatGPT.
PerplexityBot – робот, используемый для поисковых функций Perplexity.
Claude-SearchBot – робот Anthropic, связанный с поисковыми функциями Claude.
Доступ этих систем к сайту может быть важен для получения актуальной информации, но не гарантирует, что компания будет упомянута или рекомендована в ответе ИИ.
Краулеры для обучения моделей.
GPTBot – робот OpenAI, предназначенный для сбора контента, потенциально используемого при обучении моделей.
ClaudeBot – робот Anthropic, связанный со сбором данных для обучения моделей.
Это другая задача, отличная от предоставления пользователю поискового ответа со ссылкой на сайт. Владелец ресурса может быть заинтересован в доступности сайта для AI Search, но при этом предпочитать ограничивать сбор материалов для обучения моделей.
Пользовательские ИИ-агенты. Есть и ещё одна категория автоматизированных обращений.
Например, ChatGPT-User может получать информацию с сайта в рамках конкретного пользовательского запроса. Такое обращение отличается от регулярного сканирования сайта поисковым роботом.
Поэтому при анализе журналов важно учитывать не только название бота, но и его назначение.
Что скрывается за именами Gort и QlyzeBot? Почему ответы нужно проверять
Если назначение известных роботов, таких как OAI-SearchBot и PerplexityBot, описано в документации их операторов, то имена QlyzeBot и Gort заставили меня провести небольшое расследование.
Я обратилась к Google ИИ, который предложил несколько объяснений. Однако при дополнительной проверке выяснилось, что подтвердить их достоверность по официальным источникам не удалось.
Важный урок для владельца сайта: не каждый робот, обнаруженный в серверных журналах, имеет общедоступную документацию. Но неизвестное имя ещё не означает угрозу.
Поэтому сначала стоит проверить частоту запросов, запрашиваемые страницы, IP-адреса и нагрузку на сервер. Если обнаружена подозрительная активность или чрезмерная нагрузка, можно применить ограничения через межсетевой экран веб-приложений (WAF).
И главное – не стоит менять настройки сайта только на основании уверенного ответа ИИ без проверки источников.
По одному названию User-Agent нельзя достоверно определить владельца неизвестного робота, его задачи или безопасность.
Ещё один момент: Google ИИ разделил роботов для обучения моделей и AI Search, но сделал слишком категоричный вывод, что поисковые ИИ-боты обязательно приведут новых клиентов и кликабельные ссылки. Это не гарантировано.
Поэтому я не стала автоматически переносить предложенные ограничения в настройки сайта.
Я обратилась к Google ИИ, который предложил несколько объяснений. Однако при дополнительной проверке выяснилось, что подтвердить их достоверность по официальным источникам не удалось.
- QlyzeBot – идентификатор краулера, встречающийся в специализированных каталогах. Но достоверно установить его владельца и цель обращения к моему сайту пока не удалось.
- Gort – идентификатор автоматизированного клиента, происхождение которого также не подтверждено. Google ИИ предположил его связь с OpenAI, однако официального подтверждения этой версии я не нашла.
Важный урок для владельца сайта: не каждый робот, обнаруженный в серверных журналах, имеет общедоступную документацию. Но неизвестное имя ещё не означает угрозу.
Поэтому сначала стоит проверить частоту запросов, запрашиваемые страницы, IP-адреса и нагрузку на сервер. Если обнаружена подозрительная активность или чрезмерная нагрузка, можно применить ограничения через межсетевой экран веб-приложений (WAF).
И главное – не стоит менять настройки сайта только на основании уверенного ответа ИИ без проверки источников.
По одному названию User-Agent нельзя достоверно определить владельца неизвестного робота, его задачи или безопасность.
Ещё один момент: Google ИИ разделил роботов для обучения моделей и AI Search, но сделал слишком категоричный вывод, что поисковые ИИ-боты обязательно приведут новых клиентов и кликабельные ссылки. Это не гарантировано.
Поэтому я не стала автоматически переносить предложенные ограничения в настройки сайта.
Какой вывод я сделала. ИИ полезен для первичного анализа, объяснения терминов и подготовки рекомендаций. Но если речь идёт о технических настройках сайта, особенно о блокировке поисковых систем, рекомендации необходимо проверять.
Для принятия решения желательно учитывать реальные URL запросов, частоту обращений, нагрузку на сервер, IP-адреса и официальную документацию операторов.
Неизвестный робот не обязательно опасен. А известный User-Agent не обязательно подлинный.
Что это означает для SEO, GEO и AI Search
Для традиционного SEO важны доступность страниц поисковым системам, корректная индексация, качество контента и получение органического трафика.
Для GEO и AI Search появляется дополнительная задача – сделать информацию о компании понятной, актуальной, проверяемой и пригодной для использования в ответах ИИ. Но увеличение количества обращений роботов само по себе нельзя считать ростом GEO-видимости.
Для GEO и AI Search появляется дополнительная задача – сделать информацию о компании понятной, актуальной, проверяемой и пригодной для использования в ответах ИИ. Но увеличение количества обращений роботов само по себе нельзя считать ростом GEO-видимости.
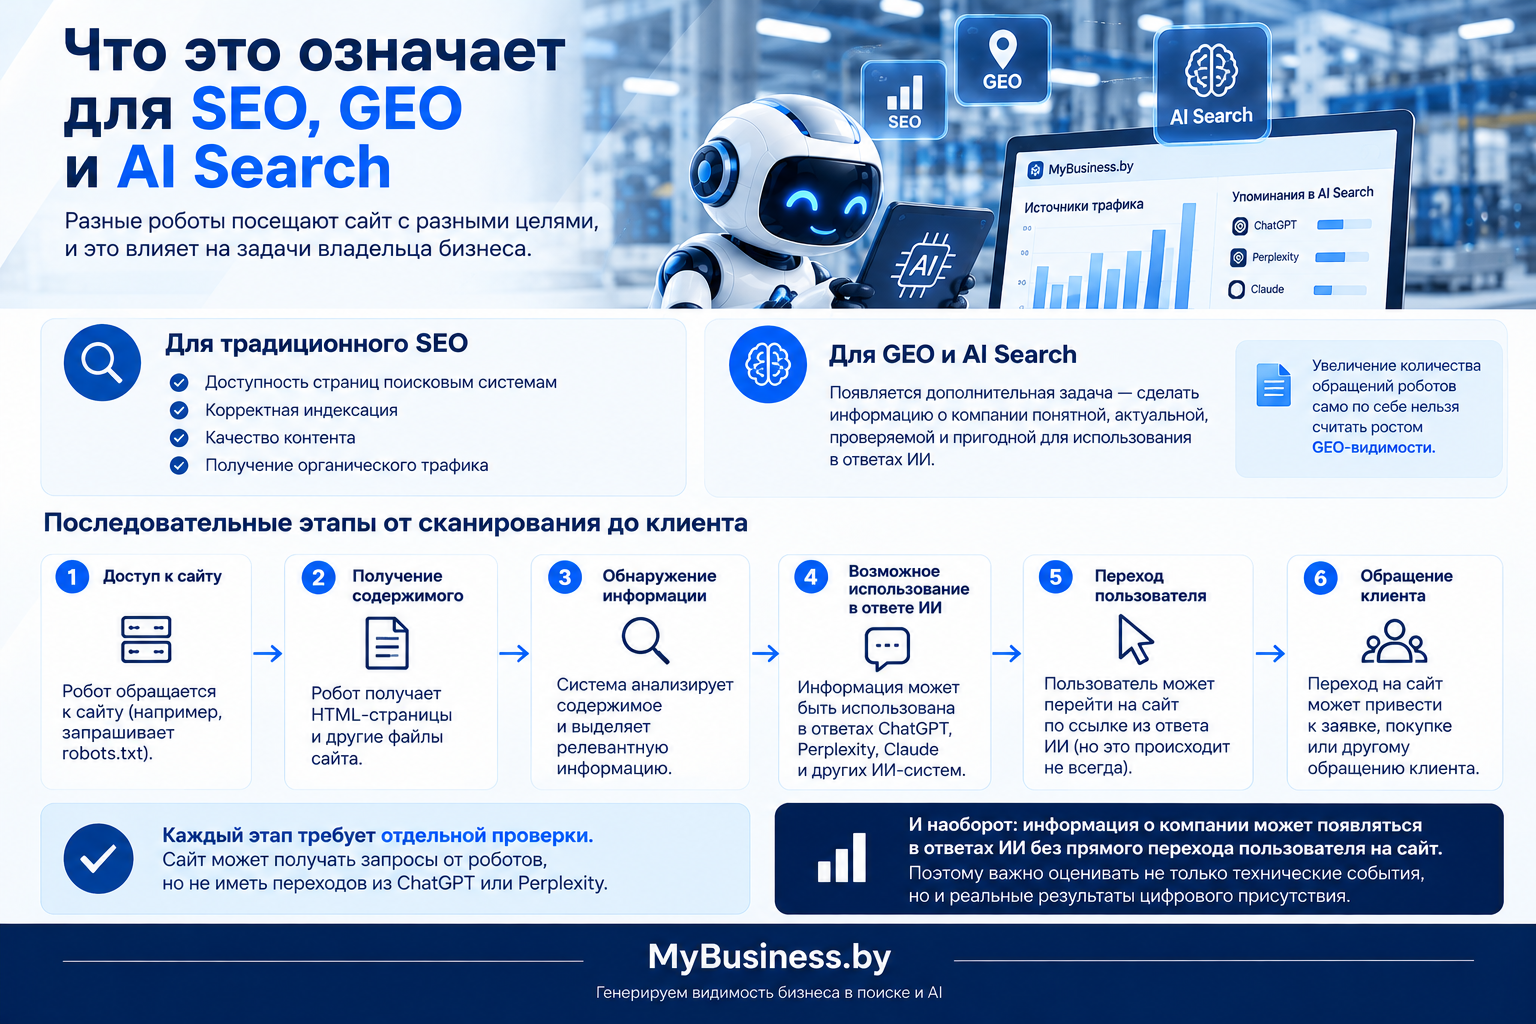
Полезно различать последовательные этапы: Доступ к сайту → получение содержимого → обнаружение информации → возможное использование в ответе ИИ → переход пользователя → обращение клиента.
Каждый этап требует отдельной проверки. Сайт может получать запросы от роботов, но не иметь переходов из ChatGPT или Perplexity. И наоборот: информация о компании может появляться в ответах ИИ без прямого перехода пользователя на сайт. Поэтому владельцам бизнеса важно оценивать не только технические события, но и реальные результаты цифрового присутствия.
Что делать владельцу сайта: пять практических шагов
Шаг 1. Узнайте, какие роботы обращаются к сайту. Информацию можно получить из серверных журналов хостинга, Cloudflare или технического отчёта разработчика.
Google Search Console и Bing Webmaster Tools помогают анализировать сканирование соответствующими поисковыми системами. Обычная веб-аналитика, например Google Analytics или Яндекс.Метрика, не заменяет серверные журналы при исследовании роботов.
Если вы не занимаетесь техническим администрированием, достаточно попросить специалиста проверить, какие автоматизированные системы обращаются к вашему сайту.
Шаг 2. Проверьте robots.txt. Файл robots.txt содержит инструкции для поисковых роботов и других автоматизированных систем. Обычно он доступен по адресу: https://ваш-домен/robots.txt С его помощью можно управлять разрешениями на сканирование определённых разделов сайта.
При этом robots.txt не является системой защиты конфиденциальных данных и не гарантирует соблюдение правил всеми автоматизированными клиентами. Например, можно отдельно управлять доступом OAI-SearchBot и GPTBot, поскольку эти роботы выполняют разные задачи.
Но готовые правила нельзя копировать без проверки существующей конфигурации сайта.
Шаг 3. Убедитесь, что важные страницы доступны. Проверьте, открываются ли основные страницы, доступны ли sitemap.xml и HTML-содержимое, нет ли ошибочных ограничений для поисковых систем.
Ответ HTTP 200 означает, что сервер успешно обработал запрос, но не гарантирует индексацию или использование содержимого в ответах ИИ.
Шаг 4. Не блокируйте неизвестных роботов автоматически. Если неизвестный робот не создаёт заметной нагрузки и нет признаков злоупотребления, сначала соберите дополнительную информацию. Если обращения слишком частые или подозрительные, можно рассмотреть ограничения на уровне защитных систем.
Не стоит блокировать робота только потому, что ИИ назвал его бесполезным.
Шаг 5. Оценивайте результат для бизнеса. Важно понимать не только то, какие системы обращаются к сайту, но и помогают ли они потенциальным клиентам находить компанию.
Таблица 5. Какие показатели стоит отслеживать
Google Search Console и Bing Webmaster Tools помогают анализировать сканирование соответствующими поисковыми системами. Обычная веб-аналитика, например Google Analytics или Яндекс.Метрика, не заменяет серверные журналы при исследовании роботов.
Если вы не занимаетесь техническим администрированием, достаточно попросить специалиста проверить, какие автоматизированные системы обращаются к вашему сайту.
Шаг 2. Проверьте robots.txt. Файл robots.txt содержит инструкции для поисковых роботов и других автоматизированных систем. Обычно он доступен по адресу: https://ваш-домен/robots.txt С его помощью можно управлять разрешениями на сканирование определённых разделов сайта.
При этом robots.txt не является системой защиты конфиденциальных данных и не гарантирует соблюдение правил всеми автоматизированными клиентами. Например, можно отдельно управлять доступом OAI-SearchBot и GPTBot, поскольку эти роботы выполняют разные задачи.
Но готовые правила нельзя копировать без проверки существующей конфигурации сайта.
Шаг 3. Убедитесь, что важные страницы доступны. Проверьте, открываются ли основные страницы, доступны ли sitemap.xml и HTML-содержимое, нет ли ошибочных ограничений для поисковых систем.
Ответ HTTP 200 означает, что сервер успешно обработал запрос, но не гарантирует индексацию или использование содержимого в ответах ИИ.
Шаг 4. Не блокируйте неизвестных роботов автоматически. Если неизвестный робот не создаёт заметной нагрузки и нет признаков злоупотребления, сначала соберите дополнительную информацию. Если обращения слишком частые или подозрительные, можно рассмотреть ограничения на уровне защитных систем.
Не стоит блокировать робота только потому, что ИИ назвал его бесполезным.
Шаг 5. Оценивайте результат для бизнеса. Важно понимать не только то, какие системы обращаются к сайту, но и помогают ли они потенциальным клиентам находить компанию.
Таблица 5. Какие показатели стоит отслеживать
Для бизнеса итоговым показателем остаются не серверные запросы, а полезные действия пользователей: обращения, заявки, продажи и другие конверсии.
Как ограничить доступ отдельных ИИ-роботов
Владелец сайта может управлять доступом некоторых роботов через файл robots.txt.
Например, можно разрешить сканирование для OAI-SearchBot, который связан с поиском ChatGPT, и запретить сканирование для GPTBot, предназначенного для сбора данных для обучения моделей.
Пример правил:
User-agent: OAI-SearchBot
Allow: /
User-agent: GPTBot
Disallow: /
Это означает, что OAI-SearchBot разрешено сканировать сайт, а GPTBot получает указание не сканировать его.
Важно: robots.txt – это инструкции для роботов, а не техническая защита от доступа. Добросовестные роботы соблюдают эти правила, но неизвестные автоматизированные программы могут их игнорировать.
Например, можно разрешить сканирование для OAI-SearchBot, который связан с поиском ChatGPT, и запретить сканирование для GPTBot, предназначенного для сбора данных для обучения моделей.
Пример правил:
User-agent: OAI-SearchBot
Allow: /
User-agent: GPTBot
Disallow: /
Это означает, что OAI-SearchBot разрешено сканировать сайт, а GPTBot получает указание не сканировать его.
Важно: robots.txt – это инструкции для роботов, а не техническая защита от доступа. Добросовестные роботы соблюдают эти правила, но неизвестные автоматизированные программы могут их игнорировать.
Если бот создаёт чрезмерную нагрузку или ведёт себя подозрительно, ограничения можно настроить через Cloudflare или другой межсетевой экран веб-приложений (WAF). При этом блокировать неизвестных роботов без анализа их поведения не рекомендуется.
Можно ли поручить мониторинг AI-агенту?
Да, если у агента есть доступ к соответствующим данным. В моём эксперименте AI-агент ежедневно анализирует доступные журналы Cloudflare Worker, данные Quick Check и результаты контрольных поисковых проверок.
Он группирует обращения, выявляет технические ошибки, сравнивает показатели с предыдущим днём и формирует отчёт.
Он группирует обращения, выявляет технические ошибки, сравнивает показатели с предыдущим днём и формирует отчёт.
Пример задания для AI-агента:
Ежедневно анализируй доступные серверные логи сайта.
Показывай идентификаторы поисковых и ИИ-роботов, количество запросов, запрошенные URL и HTTP-статусы.
Отдельно учитывай обращения к robots.txt и HTML-страницам.
Сравнивай показатели с предыдущим днём.
Не считай серверные запросы уникальными посетителями.
Если подлинность робота не подтверждена, прямо указывай это.
Не изменяй технические настройки сайта без моего подтверждения.
Такой мониторинг помогает экономить время и замечать изменения, которые могут остаться незамеченными в обычной аналитике.
Но AI-агент не должен придумывать отсутствующие показатели. Если у него нет данных о посетителях или конверсиях, он должен прямо сообщать об этом.
Но AI-агент не должен придумывать отсутствующие показатели. Если у него нет данных о посетителях или конверсиях, он должен прямо сообщать об этом.
Главный вывод моего эксперимента
Мой AI-агент обнаружил в журналах сайта обращения с идентификаторами поисковых и ИИ-роботов OpenAI, Perplexity, Anthropic, Microsoft и менее известных систем.
Отдельная контрольная проверка показала, что русская и английская страницы Lab обнаруживаются в ChatGPT Search по проверенному запросу.
Однако сам факт обращения робота не означает, что компания появилась в ответах ИИ или получила новых клиентов. Поэтому я продолжаю наблюдение: сравниваю технические сигналы, доступность страниц, результаты поисковых проверок и реальные показатели посещаемости.
Главный вопрос для малого бизнеса сегодня – не сколько роботов посетило сайт, а могут ли поисковые и ИИ-системы получить достоверную информацию о компании и помогает ли это потенциальным клиентам находить бизнес.
Отдельная контрольная проверка показала, что русская и английская страницы Lab обнаруживаются в ChatGPT Search по проверенному запросу.
Однако сам факт обращения робота не означает, что компания появилась в ответах ИИ или получила новых клиентов. Поэтому я продолжаю наблюдение: сравниваю технические сигналы, доступность страниц, результаты поисковых проверок и реальные показатели посещаемости.
Главный вопрос для малого бизнеса сегодня – не сколько роботов посетило сайт, а могут ли поисковые и ИИ-системы получить достоверную информацию о компании и помогает ли это потенциальным клиентам находить бизнес.
Часто задаваемые вопросы (FAQ)
1. Что такое поисковый робот?
Поисковый робот – автоматизированная программа, которая посещает сайты, обнаруживает страницы и передаёт информацию поисковой системе для дальнейшей обработки. Примеры – Googlebot, YandexBot и Bingbot. Посещение робота не гарантирует индексацию страницы.
2. Чем ИИ-краулер отличается от обычного поискового робота?
Основное отличие – назначение. Традиционные поисковые роботы помогают формировать поисковый индекс, а ИИ-краулеры могут собирать информацию для AI Search, обучения моделей или выполнения пользовательских запросов. Некоторые системы совмещают несколько технологий.
3. Зачем OAI-SearchBot посещает мой сайт?
OAI-SearchBot – робот OpenAI, связанный с поисковыми функциями ChatGPT. Он может обращаться к страницам сайта для получения информации, используемой в поиске ChatGPT. Его присутствие в логах не гарантирует, что сайт будет упомянут в ответах ИИ.
4. В чём разница между OAI-SearchBot и GPTBot?
OAI-SearchBot связан с поисковыми функциями ChatGPT, а GPTBot – со сбором контента, потенциально используемого для обучения моделей OpenAI. Владелец сайта может устанавливать для них разные правила доступа через robots.txt.
5. Нужно ли разрешать ИИ-роботам посещать сайт?
Это зависит от задач бизнеса. Если компания заинтересована в доступности информации для AI Search, имеет смысл проверить настройки доступа соответствующих роботов. При этом разрешение сканирования не гарантирует появления сайта в ответах ИИ или получения клиентов.
6. Как узнать, какие роботы посещают мой сайт?
Проверить обращения можно в серверных журналах хостинга или Cloudflare. В логах обычно доступны время запроса, URL, HTTP-статус и User-Agent. Для подтверждения подлинности известных роботов может потребоваться дополнительная проверка IP-адресов.
7. Как заблокировать нежелательного робота?
Для добросовестных роботов можно указать запрет сканирования в файле robots.txt. Если автоматизированный клиент игнорирует эти инструкции или создаёт чрезмерную нагрузку, ограничения настраивают через сервер или межсетевой экран веб-приложений (WAF).
8. Опасны ли неизвестные роботы QlyzeBot и Gort?
Само появление этих имён в логах не означает угрозу. Их происхождение в рамках моего эксперимента достоверно не подтверждено. Для оценки риска необходимо анализировать частоту запросов, запрашиваемые страницы, IP-адреса и поведение клиента.
9. Если ИИ-робот посетил сайт, появится ли компания в ChatGPT или Perplexity?
Не обязательно. Сканирование сайта, обнаружение информации, упоминание компании в ответе ИИ и переход пользователя – разные события. Ни одно из них автоматически не гарантирует следующее.
10. Как понять, приносит ли AI Search пользу бизнесу?
Следует отслеживать упоминания компании по релевантным запросам, переходы из ИИ-сервисов, обращения клиентов и конверсии. Количество запросов ИИ-роботов – технический показатель, который сам по себе не отражает коммерческий результат.
Поисковый робот – автоматизированная программа, которая посещает сайты, обнаруживает страницы и передаёт информацию поисковой системе для дальнейшей обработки. Примеры – Googlebot, YandexBot и Bingbot. Посещение робота не гарантирует индексацию страницы.
2. Чем ИИ-краулер отличается от обычного поискового робота?
Основное отличие – назначение. Традиционные поисковые роботы помогают формировать поисковый индекс, а ИИ-краулеры могут собирать информацию для AI Search, обучения моделей или выполнения пользовательских запросов. Некоторые системы совмещают несколько технологий.
3. Зачем OAI-SearchBot посещает мой сайт?
OAI-SearchBot – робот OpenAI, связанный с поисковыми функциями ChatGPT. Он может обращаться к страницам сайта для получения информации, используемой в поиске ChatGPT. Его присутствие в логах не гарантирует, что сайт будет упомянут в ответах ИИ.
4. В чём разница между OAI-SearchBot и GPTBot?
OAI-SearchBot связан с поисковыми функциями ChatGPT, а GPTBot – со сбором контента, потенциально используемого для обучения моделей OpenAI. Владелец сайта может устанавливать для них разные правила доступа через robots.txt.
5. Нужно ли разрешать ИИ-роботам посещать сайт?
Это зависит от задач бизнеса. Если компания заинтересована в доступности информации для AI Search, имеет смысл проверить настройки доступа соответствующих роботов. При этом разрешение сканирования не гарантирует появления сайта в ответах ИИ или получения клиентов.
6. Как узнать, какие роботы посещают мой сайт?
Проверить обращения можно в серверных журналах хостинга или Cloudflare. В логах обычно доступны время запроса, URL, HTTP-статус и User-Agent. Для подтверждения подлинности известных роботов может потребоваться дополнительная проверка IP-адресов.
7. Как заблокировать нежелательного робота?
Для добросовестных роботов можно указать запрет сканирования в файле robots.txt. Если автоматизированный клиент игнорирует эти инструкции или создаёт чрезмерную нагрузку, ограничения настраивают через сервер или межсетевой экран веб-приложений (WAF).
8. Опасны ли неизвестные роботы QlyzeBot и Gort?
Само появление этих имён в логах не означает угрозу. Их происхождение в рамках моего эксперимента достоверно не подтверждено. Для оценки риска необходимо анализировать частоту запросов, запрашиваемые страницы, IP-адреса и поведение клиента.
9. Если ИИ-робот посетил сайт, появится ли компания в ChatGPT или Perplexity?
Не обязательно. Сканирование сайта, обнаружение информации, упоминание компании в ответе ИИ и переход пользователя – разные события. Ни одно из них автоматически не гарантирует следующее.
10. Как понять, приносит ли AI Search пользу бизнесу?
Следует отслеживать упоминания компании по релевантным запросам, переходы из ИИ-сервисов, обращения клиентов и конверсии. Количество запросов ИИ-роботов – технический показатель, который сам по себе не отражает коммерческий результат.
А ваш сайт готов к поиску с использованием ИИ?
Знаете ли вы, какие поисковые и ИИ-роботы могут посещать ваш сайт? Нет ли технических ограничений, мешающих поисковым системам и AI Search получать информацию о вашем бизнесе?
Проверьте цифровое присутствие вашей компании. Начните с технической проверки или закажите комплексный аудит SEO, GEO и AI Search, чтобы выявить проблемы и определить, что необходимо улучшить.
Провести аудит цифрового присутствия →
Экспериментальный сайт для бесплатной проверки: MyBusiness.by – AI & Digital Presence Lab
Основной проект: MyBusiness.by
Проверьте цифровое присутствие вашей компании. Начните с технической проверки или закажите комплексный аудит SEO, GEO и AI Search, чтобы выявить проблемы и определить, что необходимо улучшить.
Провести аудит цифрового присутствия →
Экспериментальный сайт для бесплатной проверки: MyBusiness.by – AI & Digital Presence Lab
Основной проект: MyBusiness.by
Читайте также на MyBusiness.by. Поисковые и ИИ-роботы – только одна часть цифрового присутствия бизнеса. Важно также понимать, как меняется поиск, почему пользователи всё чаще получают ответы без перехода на сайт и что необходимо сделать, чтобы информацию о компании находили поисковые системы и ИИ.
Цифровое присутствие бизнеса в 2026 году
Почему бизнесу важно присутствовать на нескольких цифровых площадках и не зависеть от одного источника клиентов.
Бренд как единая сущность: SEO и AI Search
Как поисковые системы и ИИ связывают информацию о компании из разных источников.
FAQ для SEO, GEO и AI Search в 2026 году
Как использовать реальные вопросы клиентов, структурировать ответы и улучшать представление информации на сайте.
Zero-click: поиск без перехода на сайт
Почему пользователи получают ответы прямо в поиске и ИИ-сервисах, как это влияет на трафик и какие показатели стоит отслеживать.
Источники
Данные эксперимента – отчёты AI-агента по Cloudflare Worker за 12–13 октября 2026 года, контрольная проверка ChatGPT Search 14 октября и аналитика ChatGPT Sites на утро 15 октября 2026 года. Подлинность каждого робота по IP отдельно не подтверждалась.
Об использовании искусственного интеллекта. При подготовке статьи использовались инструменты искусственного интеллекта для анализа данных, структурирования информации, редактирования текста и создания инфографики. Мониторинг сайта проводился с помощью AI-агента.
Постановка задач, проверка информации, интерпретация результатов и окончательные редакционные решения выполнены автором.
MyBusiness.by, 15.10.2026